中国人工智能开源软件发展白皮书深度解读 基础软件开发的机遇与路径
引言
近日发布的《中国人工智能开源软件发展白皮书》(以下简称“白皮书”)以166页PPT的体量,系统梳理了我国人工智能开源软件的发展现状、技术趋势与生态格局。其中,人工智能基础软件开发作为整个AI技术栈的“根技术”,被置于核心位置加以论述。本文基于白皮书内容,从基础软件的定义范畴、发展现状、关键挑战与未来路径四个维度展开解读,以期为从业者与决策者提供参考。
一、人工智能基础软件的内涵与范畴
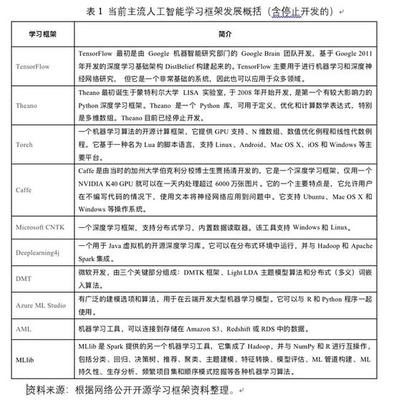
白皮书明确,人工智能基础软件是指支撑AI模型训练、推理与部署的底层软件系统,主要包括四大类:一是深度学习框架(如MindSpore、PaddlePaddle、PyTorch、TensorFlow),承担模型构建与计算图调度功能;二是编译器与运行时(如TVM、MLIR及其衍生产品),负责将高层模型高效映射到异构硬件;三是算子库与通信库(如oneDNN、NCCL及国产替代方案),提供底层计算与多卡协同能力;四是开发工具链(如模型调试、性能分析与可视化工具),贯穿AI开发全生命周期。这四层共同构成AI基础软件的“底座”,其自主可控程度直接决定上层应用与产业的创新空间。
二、发展现状:开源生态初步成型,框架竞争格局加速演变
白皮书披露的数据显示,我国AI开源软件在基础软件层面已取得阶段性进展。以深度学习框架为例,百度飞桨(PaddlePaddle)与华为昇思(MindSpore)均已形成较完整的开源社区,累计开发者规模与模型库数量快速攀升,在国内产业落地中占据一定份额。与此国际主流框架PyTorch凭借先发生态优势仍占据主导地位,但国产框架在中文文档、行业模型适配与国产硬件协同方面形成差异化竞争力。在编译器层面,以Apache TVM为代表的深度学习编译器社区中,中国企业与高校贡献度持续提升;在算子库层面,围绕国产AI芯片的算子适配工作正在加速推进。总体判断是:开源生态“从有到用”基本完成,但“从用到优”的深度与广度仍有较大提升空间。
三、关键挑战:生态壁垒、硬件适配与社区治理
白皮书在166页PPT中多次强调基础软件发展的三大结构性挑战。
第一,生态壁垒高企。深度学习框架具有显著的网络效应与迁移成本,国际主流框架已积累海量预训练模型、教程与第三方工具,后来者需要在兼容性与创新性之间找到平衡点,单靠功能对标难以实现生态突破。
第二,国产硬件适配负担重。AI基础软件的价值在于“承上启下”——向上对接框架与模型,向下对接多样化的AI芯片。国内AI芯片品类繁多、指令集与内存架构各异,基础软件层需要承担大量适配与调优工作,重复投入问题突出,亟需标准化接口与统一中间表示层的支撑。
第三,开源社区治理能力待提升。白皮书指出,部分国产开源项目存在“重发布、轻运营”倾向,贡献者结构单一、文档与测试体系不完善、商业公司与社区边界模糊等问题制约了项目的长期生命力。开源基础软件的竞争本质上是社区治理与生态运营的竞争,这一点在PPT中以多个国际项目演进案例作了对比说明。
四、发展路径:以用促研、软硬协同、开放治理
针对上述挑战,白皮书提出若干方向性建议。
其一,以用促研,场景驱动。依托我国丰富的AI应用场景(如智能制造、智慧城市、内容生成),在真实业务中打磨基础软件的性能与易用性,形成“应用反哺基础软件”的正循环。
其二,软硬协同,统一标准。推动框架、编译器与国产芯片企业联合定义中间表示与算子接口标准,降低适配成本,构建“芯片—基础软件—模型—应用”纵向贯通的协同体系。
其三,开放治理,培育社区。借鉴国际成熟开源基金会的治理经验,建立中立、透明的社区决策机制,鼓励高校、科研机构与中小企业参与贡献,提升项目的多样性与可持续性。
其四,人才先行。基础软件开发周期长、门槛高,白皮书建议加强编译技术、高性能计算与开源工程化等方向的人才培养,为生态持续注入新鲜血液。
和的应用
《中国人工智能开源软件发展白皮书》对AI基础软件开发的解读,传递出一个清晰信号:基础软件是AI开源生态的“压舱石”,其发展不能依赖单点突破,而需要框架、编译器、算子库与工具链的体系化推进,需要软硬件协同与社区治理的双轮驱动。166页PPT所呈现的不仅是现状梳理,更是一份面向从业者的行动地图——在开源开放的协作模式下,把基础软件做深做实,方能支撑中国人工智能产业的长期竞争力。
如若转载,请注明出处:http://www.bjgzbz.com/product/39.html
更新时间:2026-11-03 04:17:56